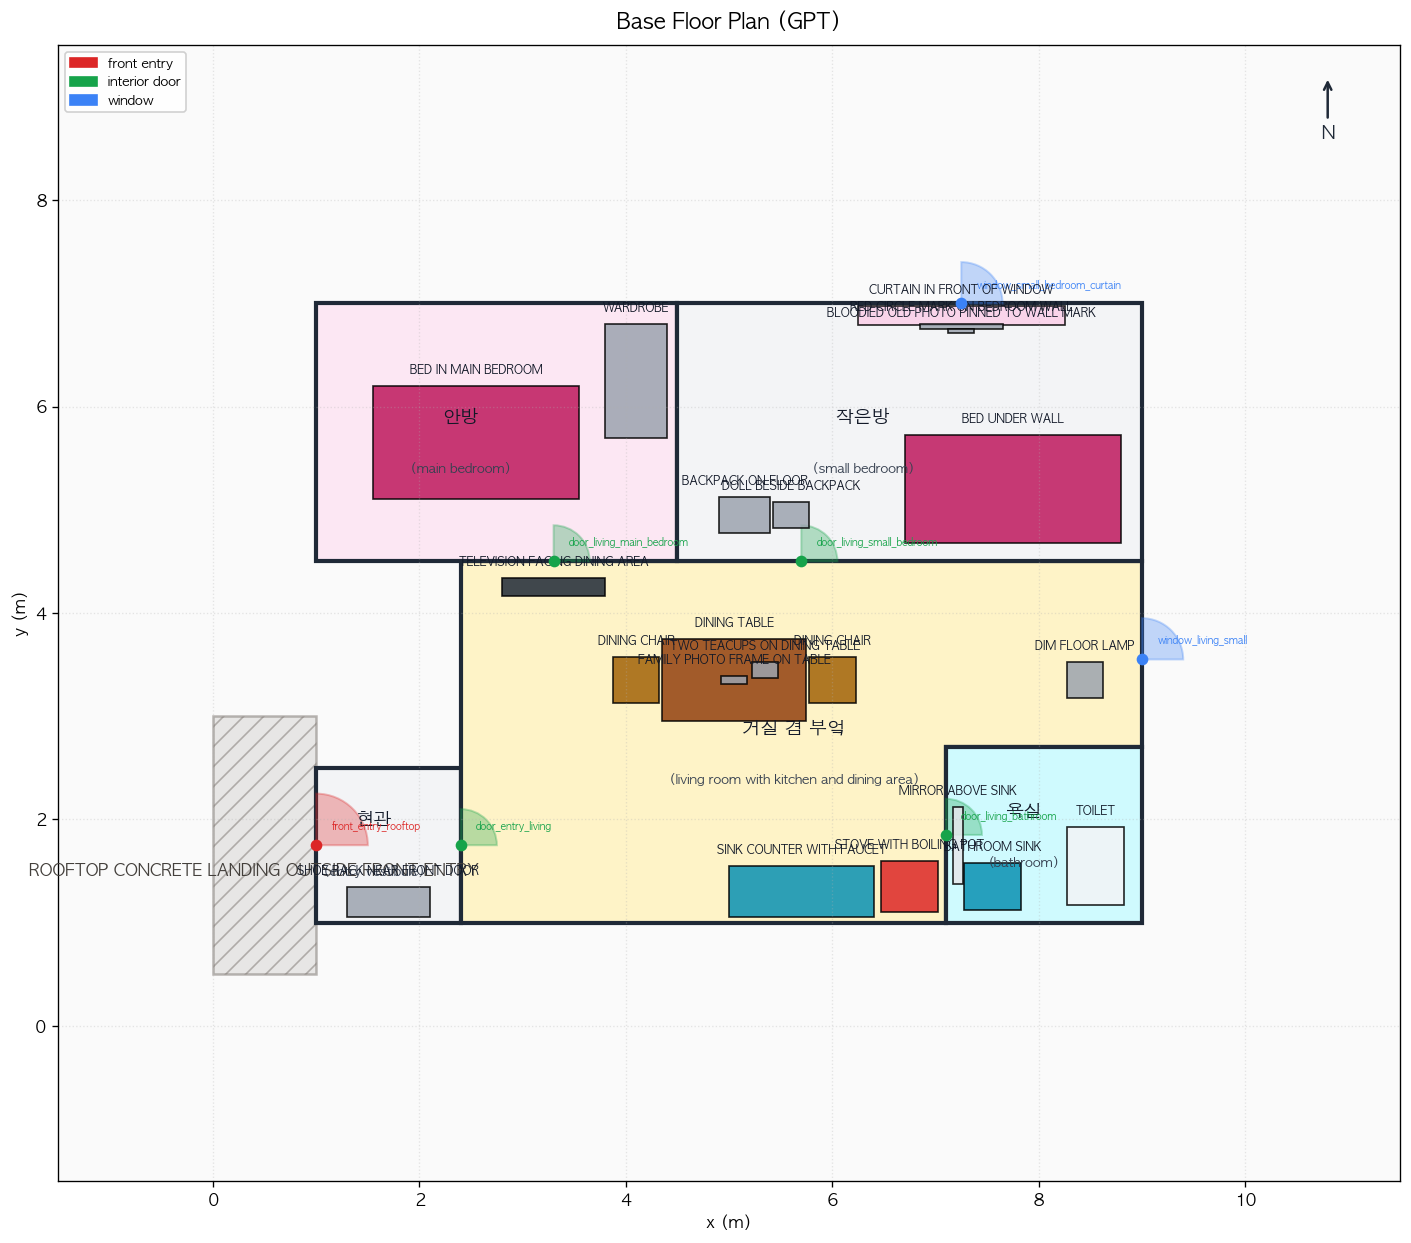
GPT-5.5
rooms=5 · doors=7 · furniture=21 · exterior=1 · rejected=4 · validation warnings=0
Gemini-3.1-pro
rooms=5 · doors=7 · furniture=13 · exterior=1 · rejected=3 · validation warnings=0
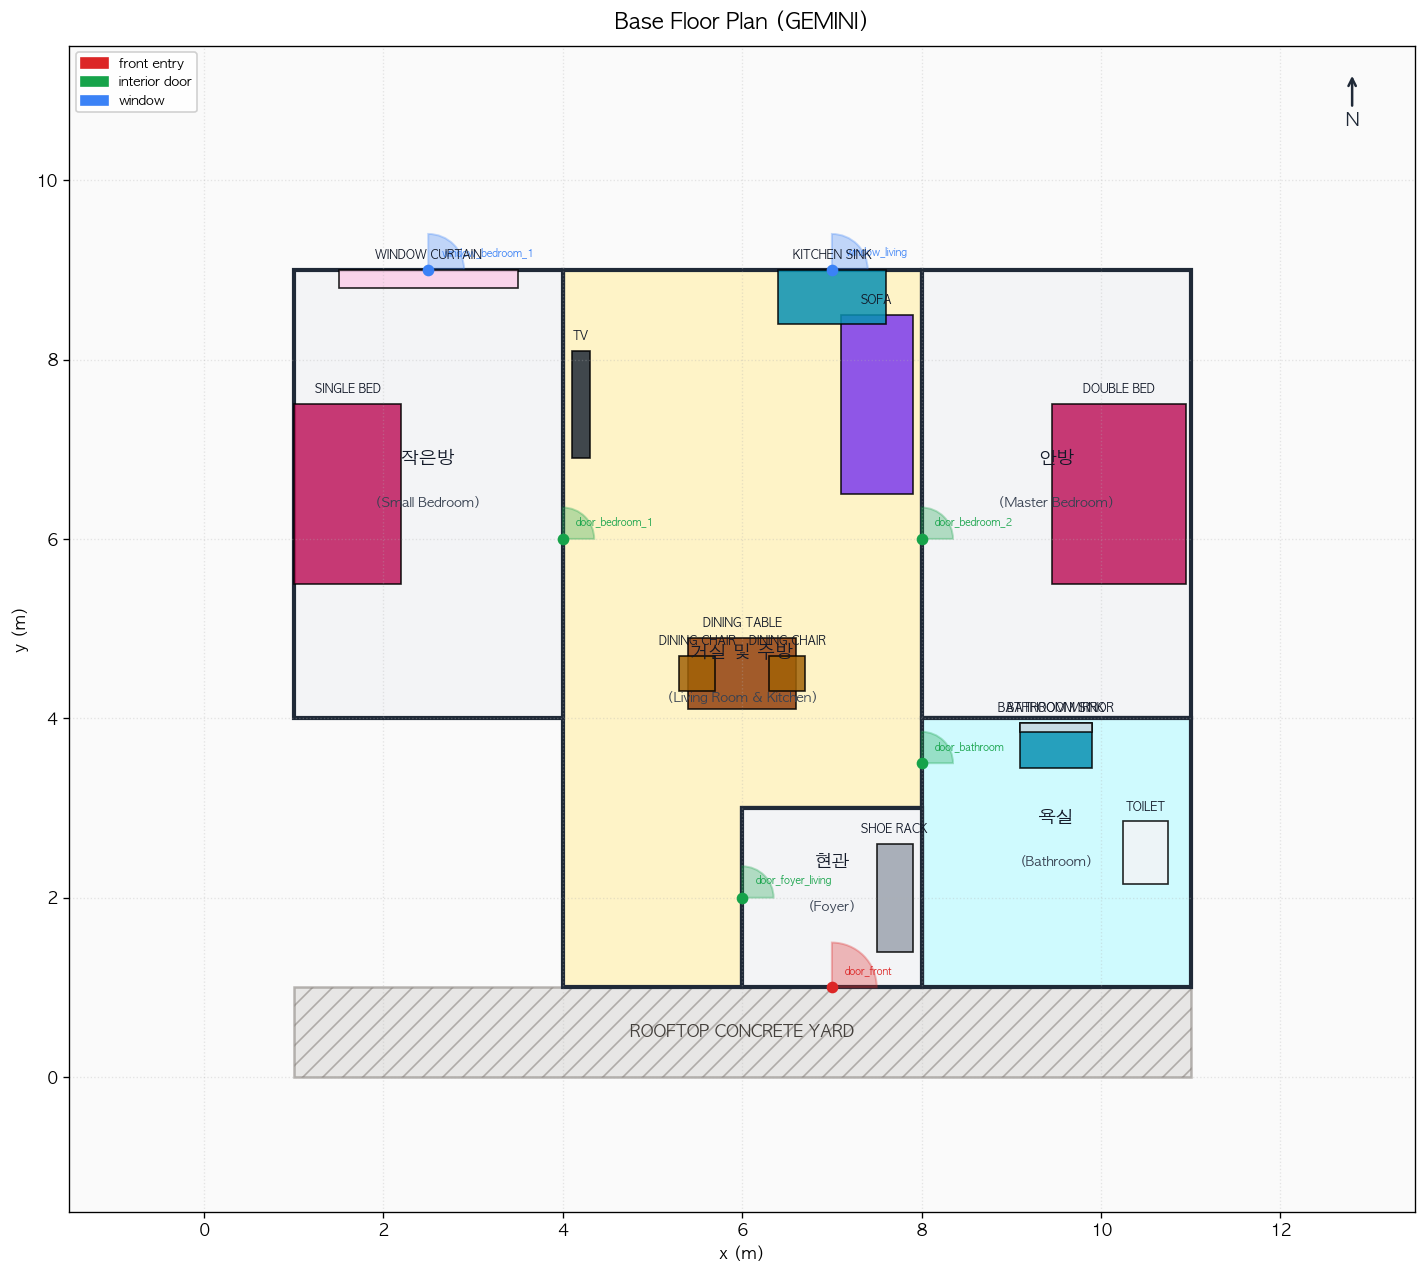
session_20260428_floor_plan_experiment.md 참조.
| 항목 | GPT-5.5 | Gemini-3.1-pro | 비고 |
|---|---|---|---|
| rooms | 5 | 5 | 거실/안방/수리영방/욕실/현관 5 zone 둘 다 식별 |
| doors | 7 | 7 | front_entry + interior 5 + window N |
| furniture | 21 | 13 | GPT가 더 디테일 (sofa, kitchen 가전 등) |
| exterior_adjacency_zones | 1 | 1 | rooftop 양쪽 모두 식별 |
| rejected_layouts | 4 | 3 | 둘 다 시나리오 contradiction 명시 |
| schema validation warnings | 0 | 0 | 가구가 room 안에 있고 door가 wall 위에 있음 |
| v3 수동 도면 핵심 요구사항 | GPT | Gemini |
|---|---|---|
| 거실 = TV(왼쪽 벽) + sofa(오른쪽 벽) 마주봄 | ? | ? |
| 거실 = sink + window 위쪽 벽 | ? | ? |
| 안방 = top-right corner + bed | ? | ? |
| 수리영방 = right side + bed + window with curtain | ? | ? |
| 욕실 = bottom-right + mirror + sink | ? | ? |
| 현관 = lower-left of apartment | ? | ? |
| front entry door 옆 ROOFTOP concrete (NOT balcony) | ? | ? |
| 모든 interior door가 거실에서 분기 | ? | ? |
→ PNG 시각 검토로 ? 항목 채울 것
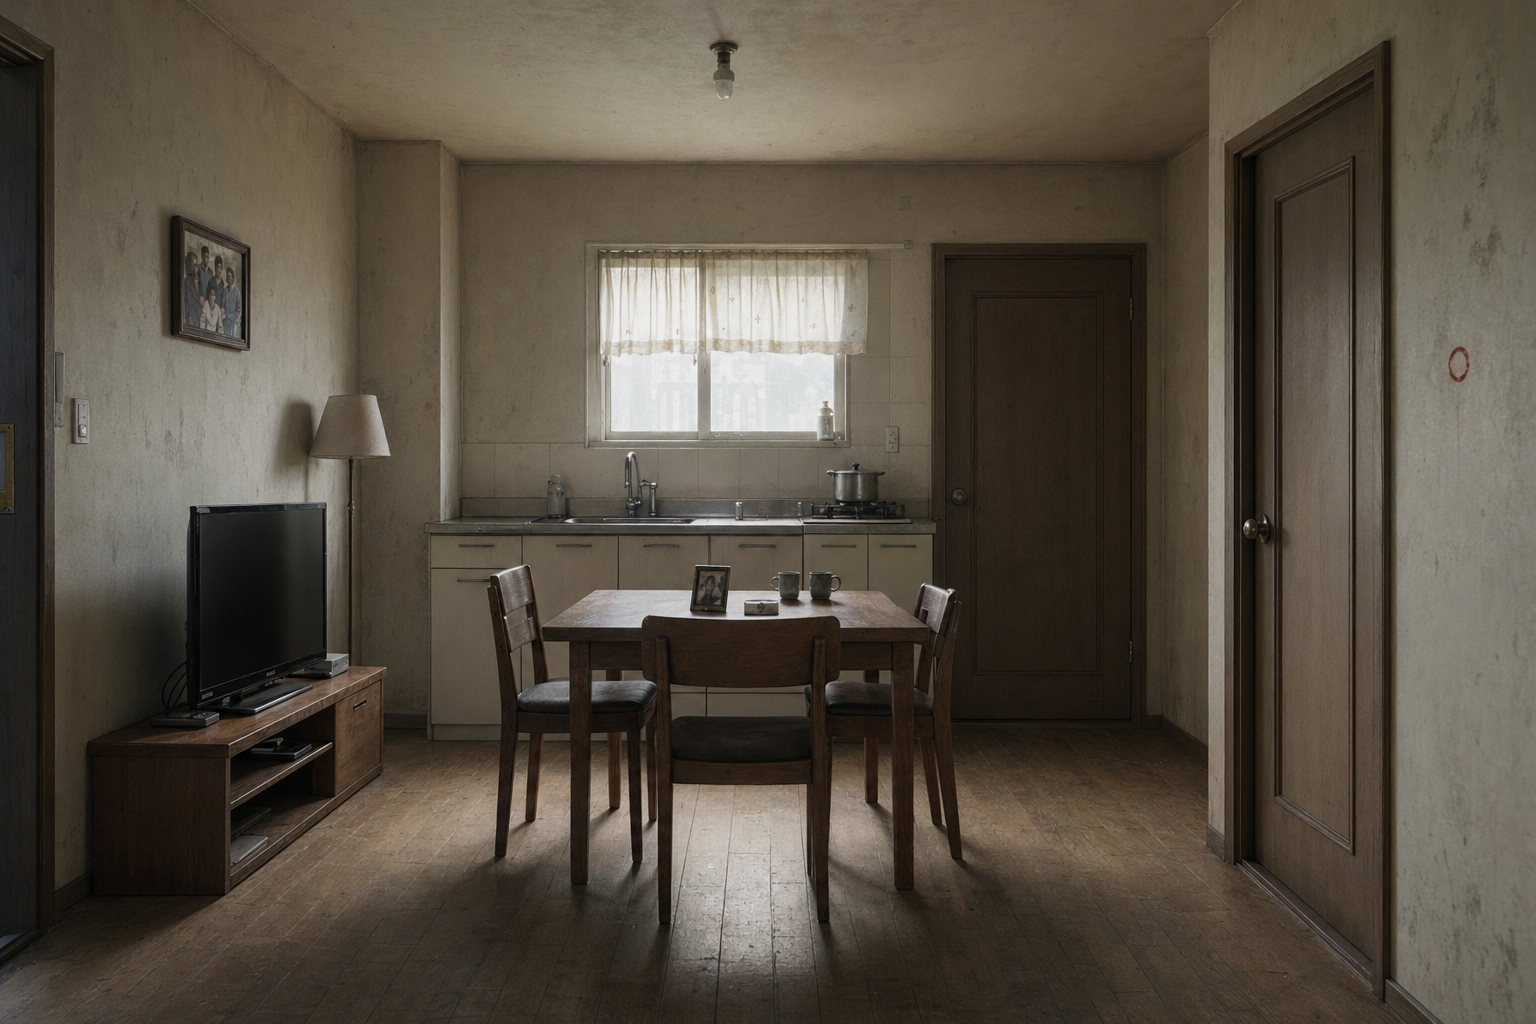
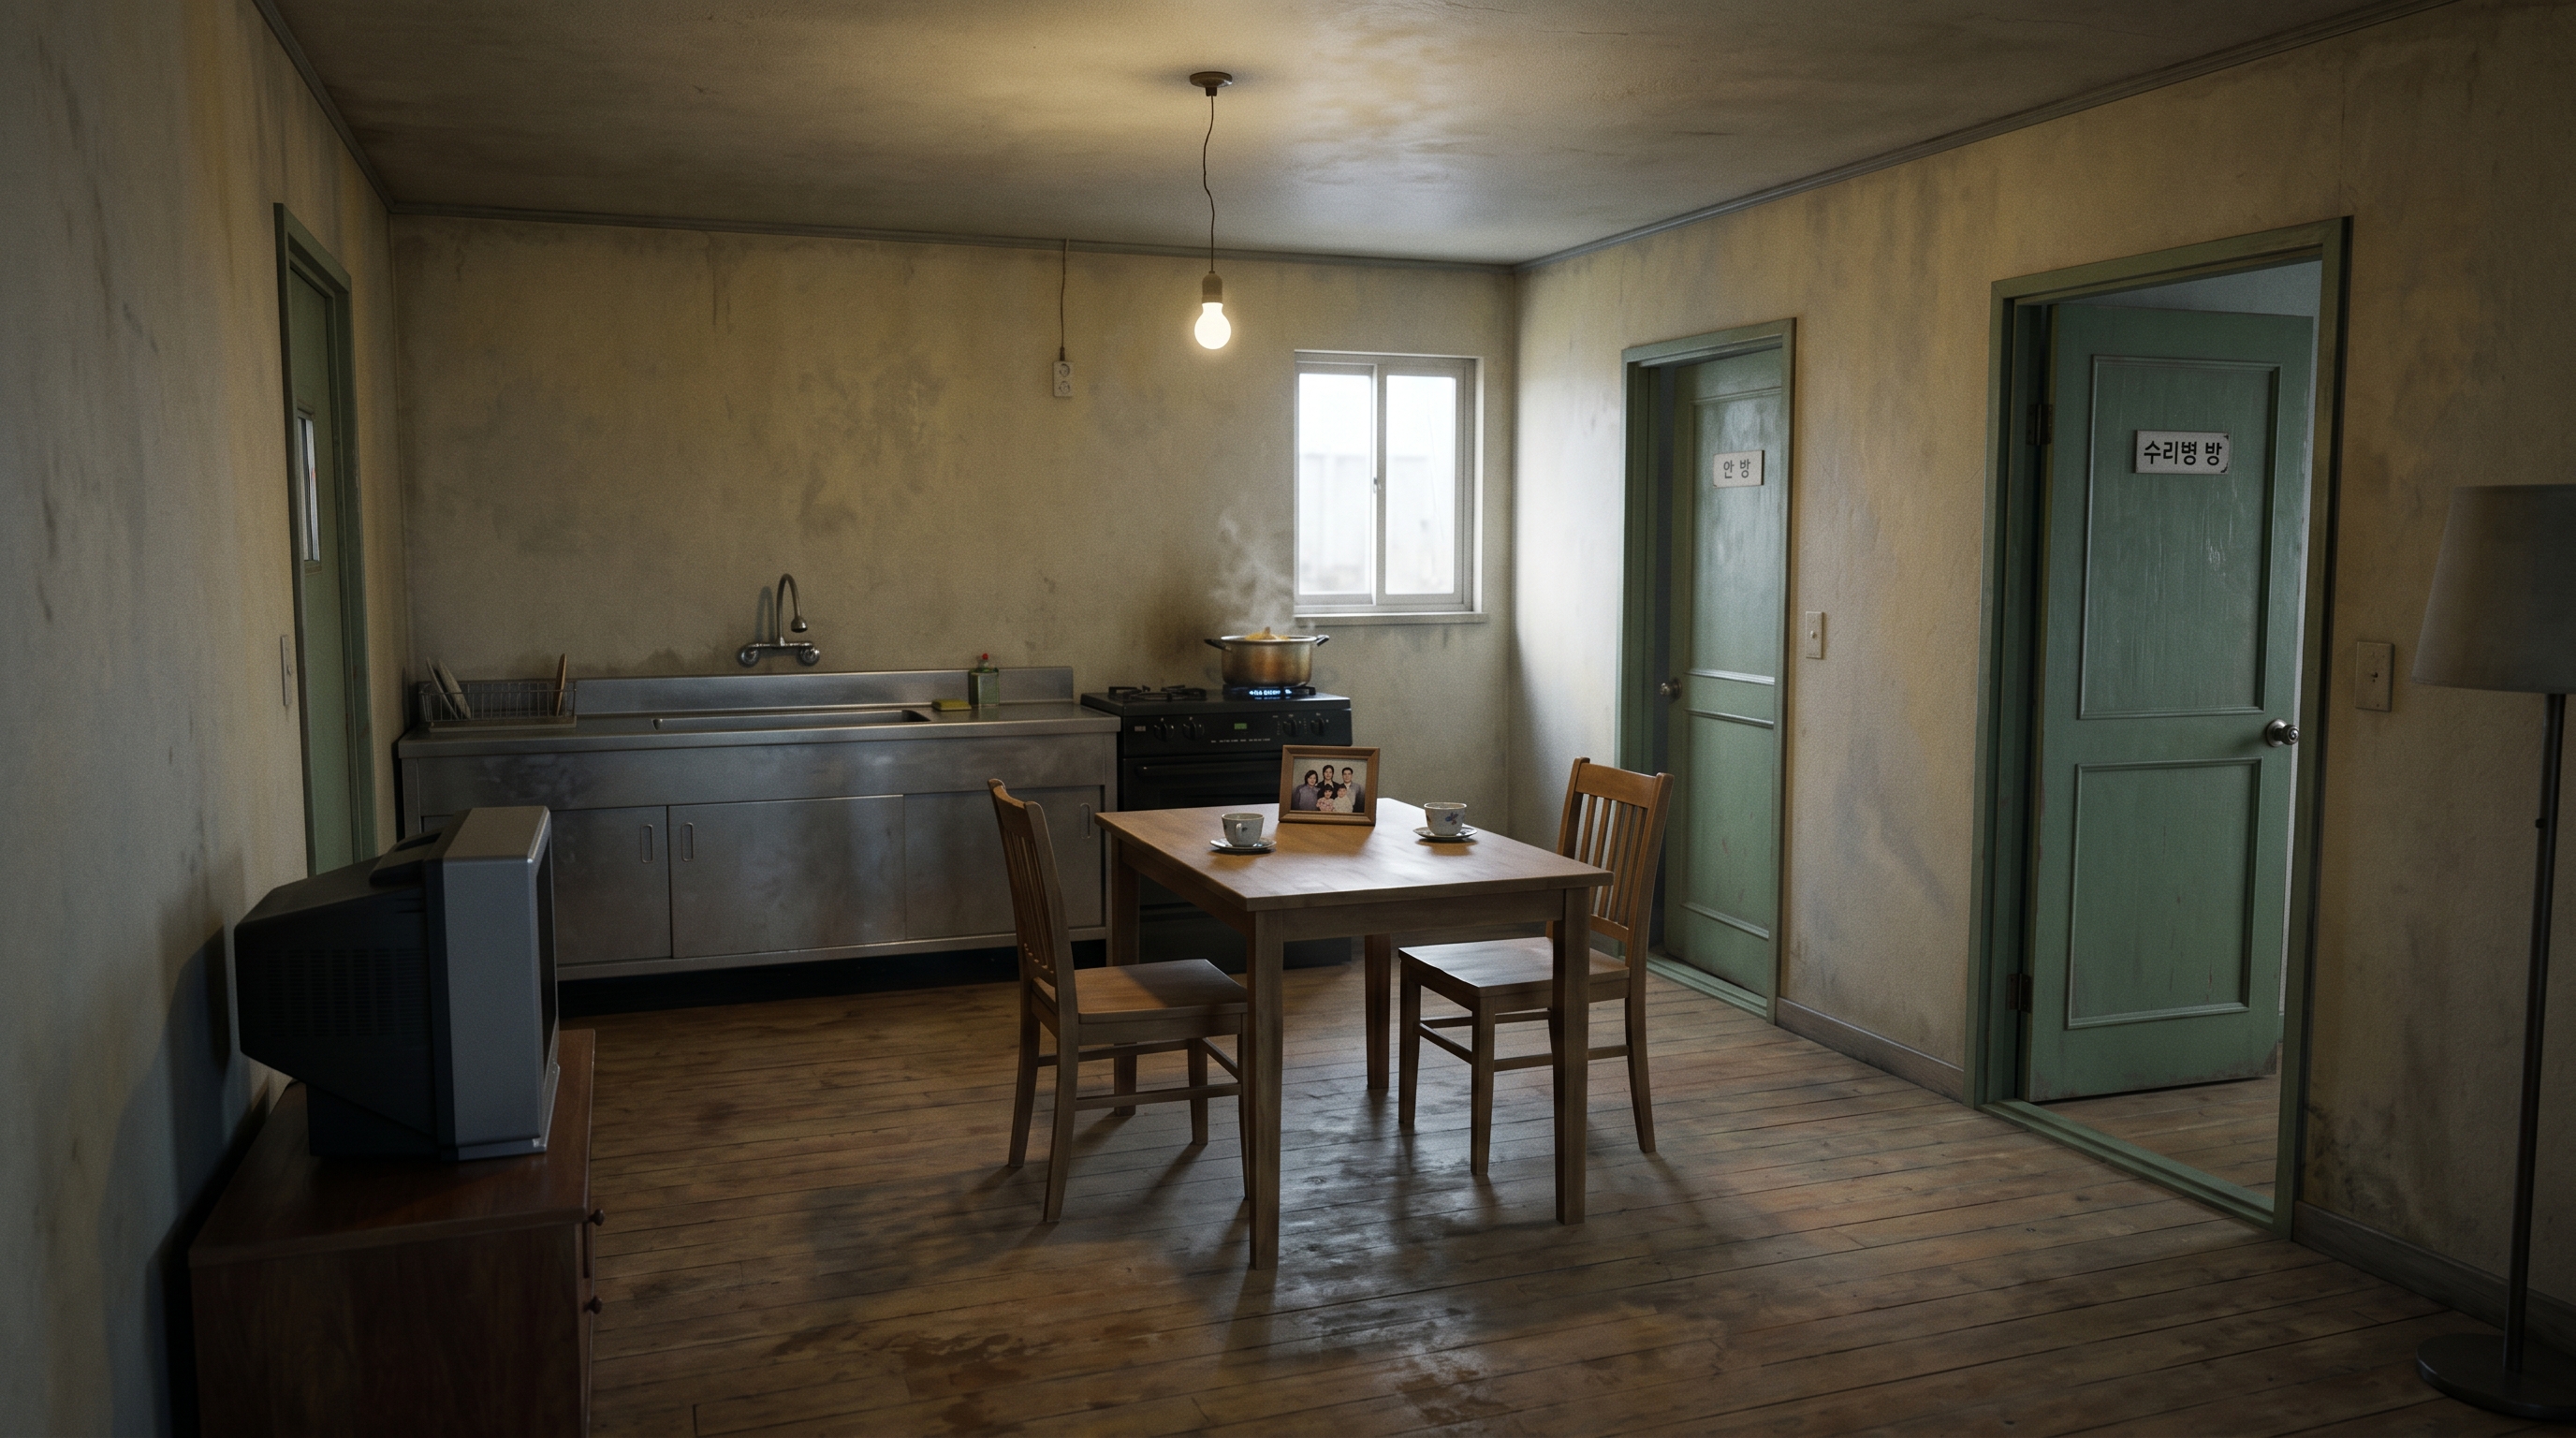
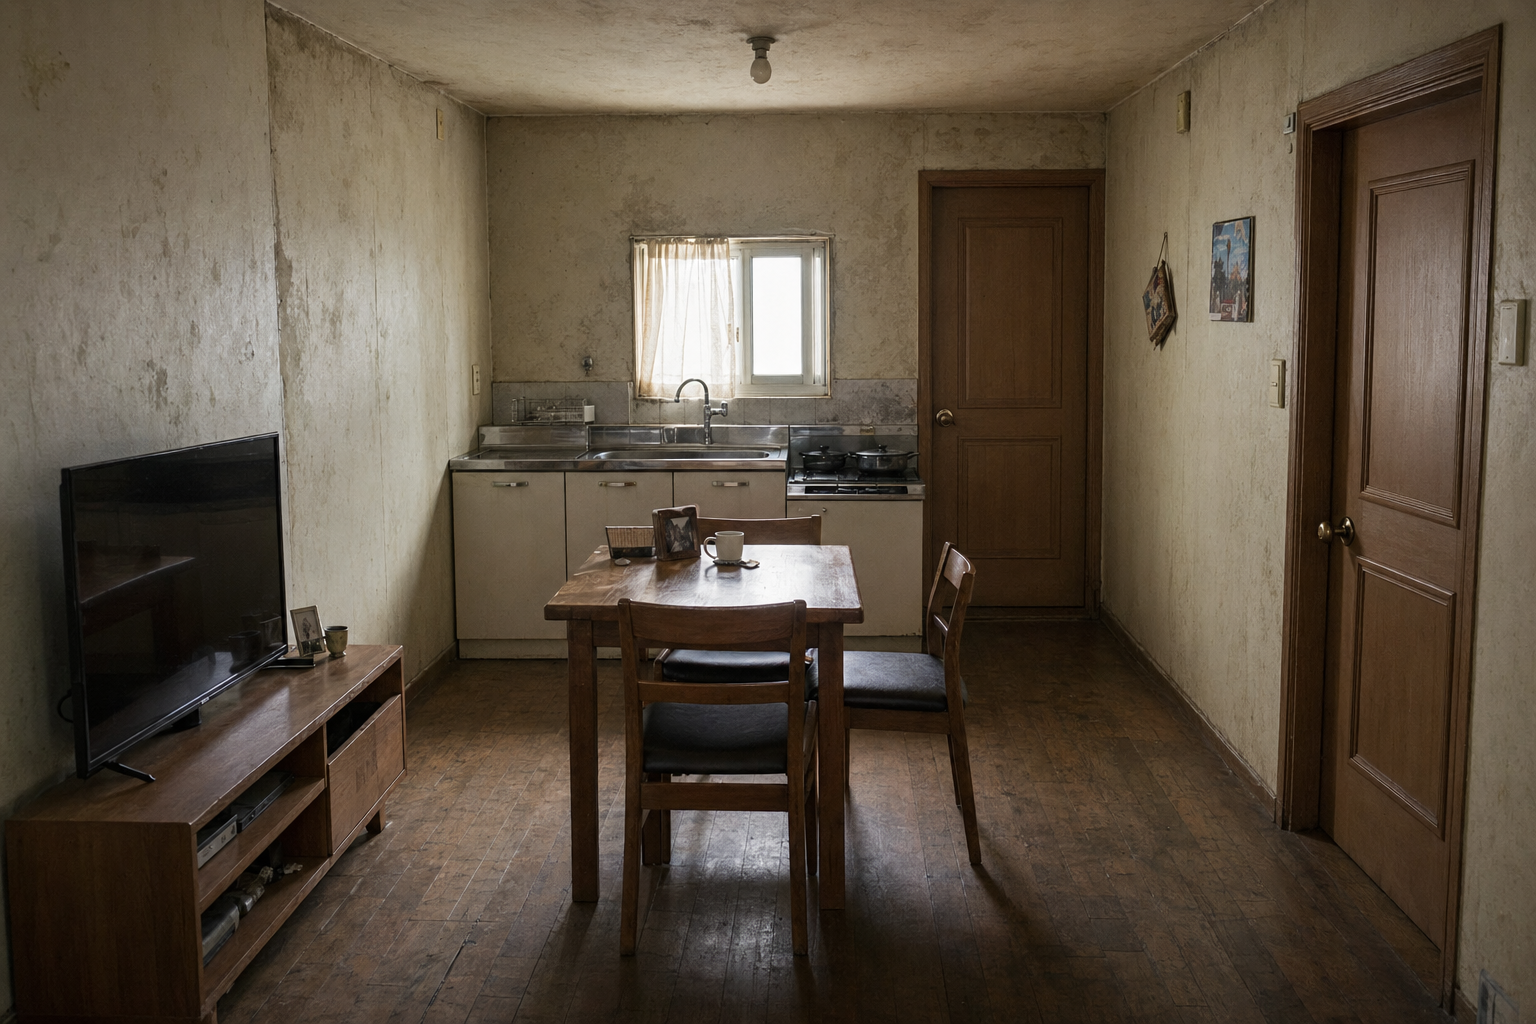
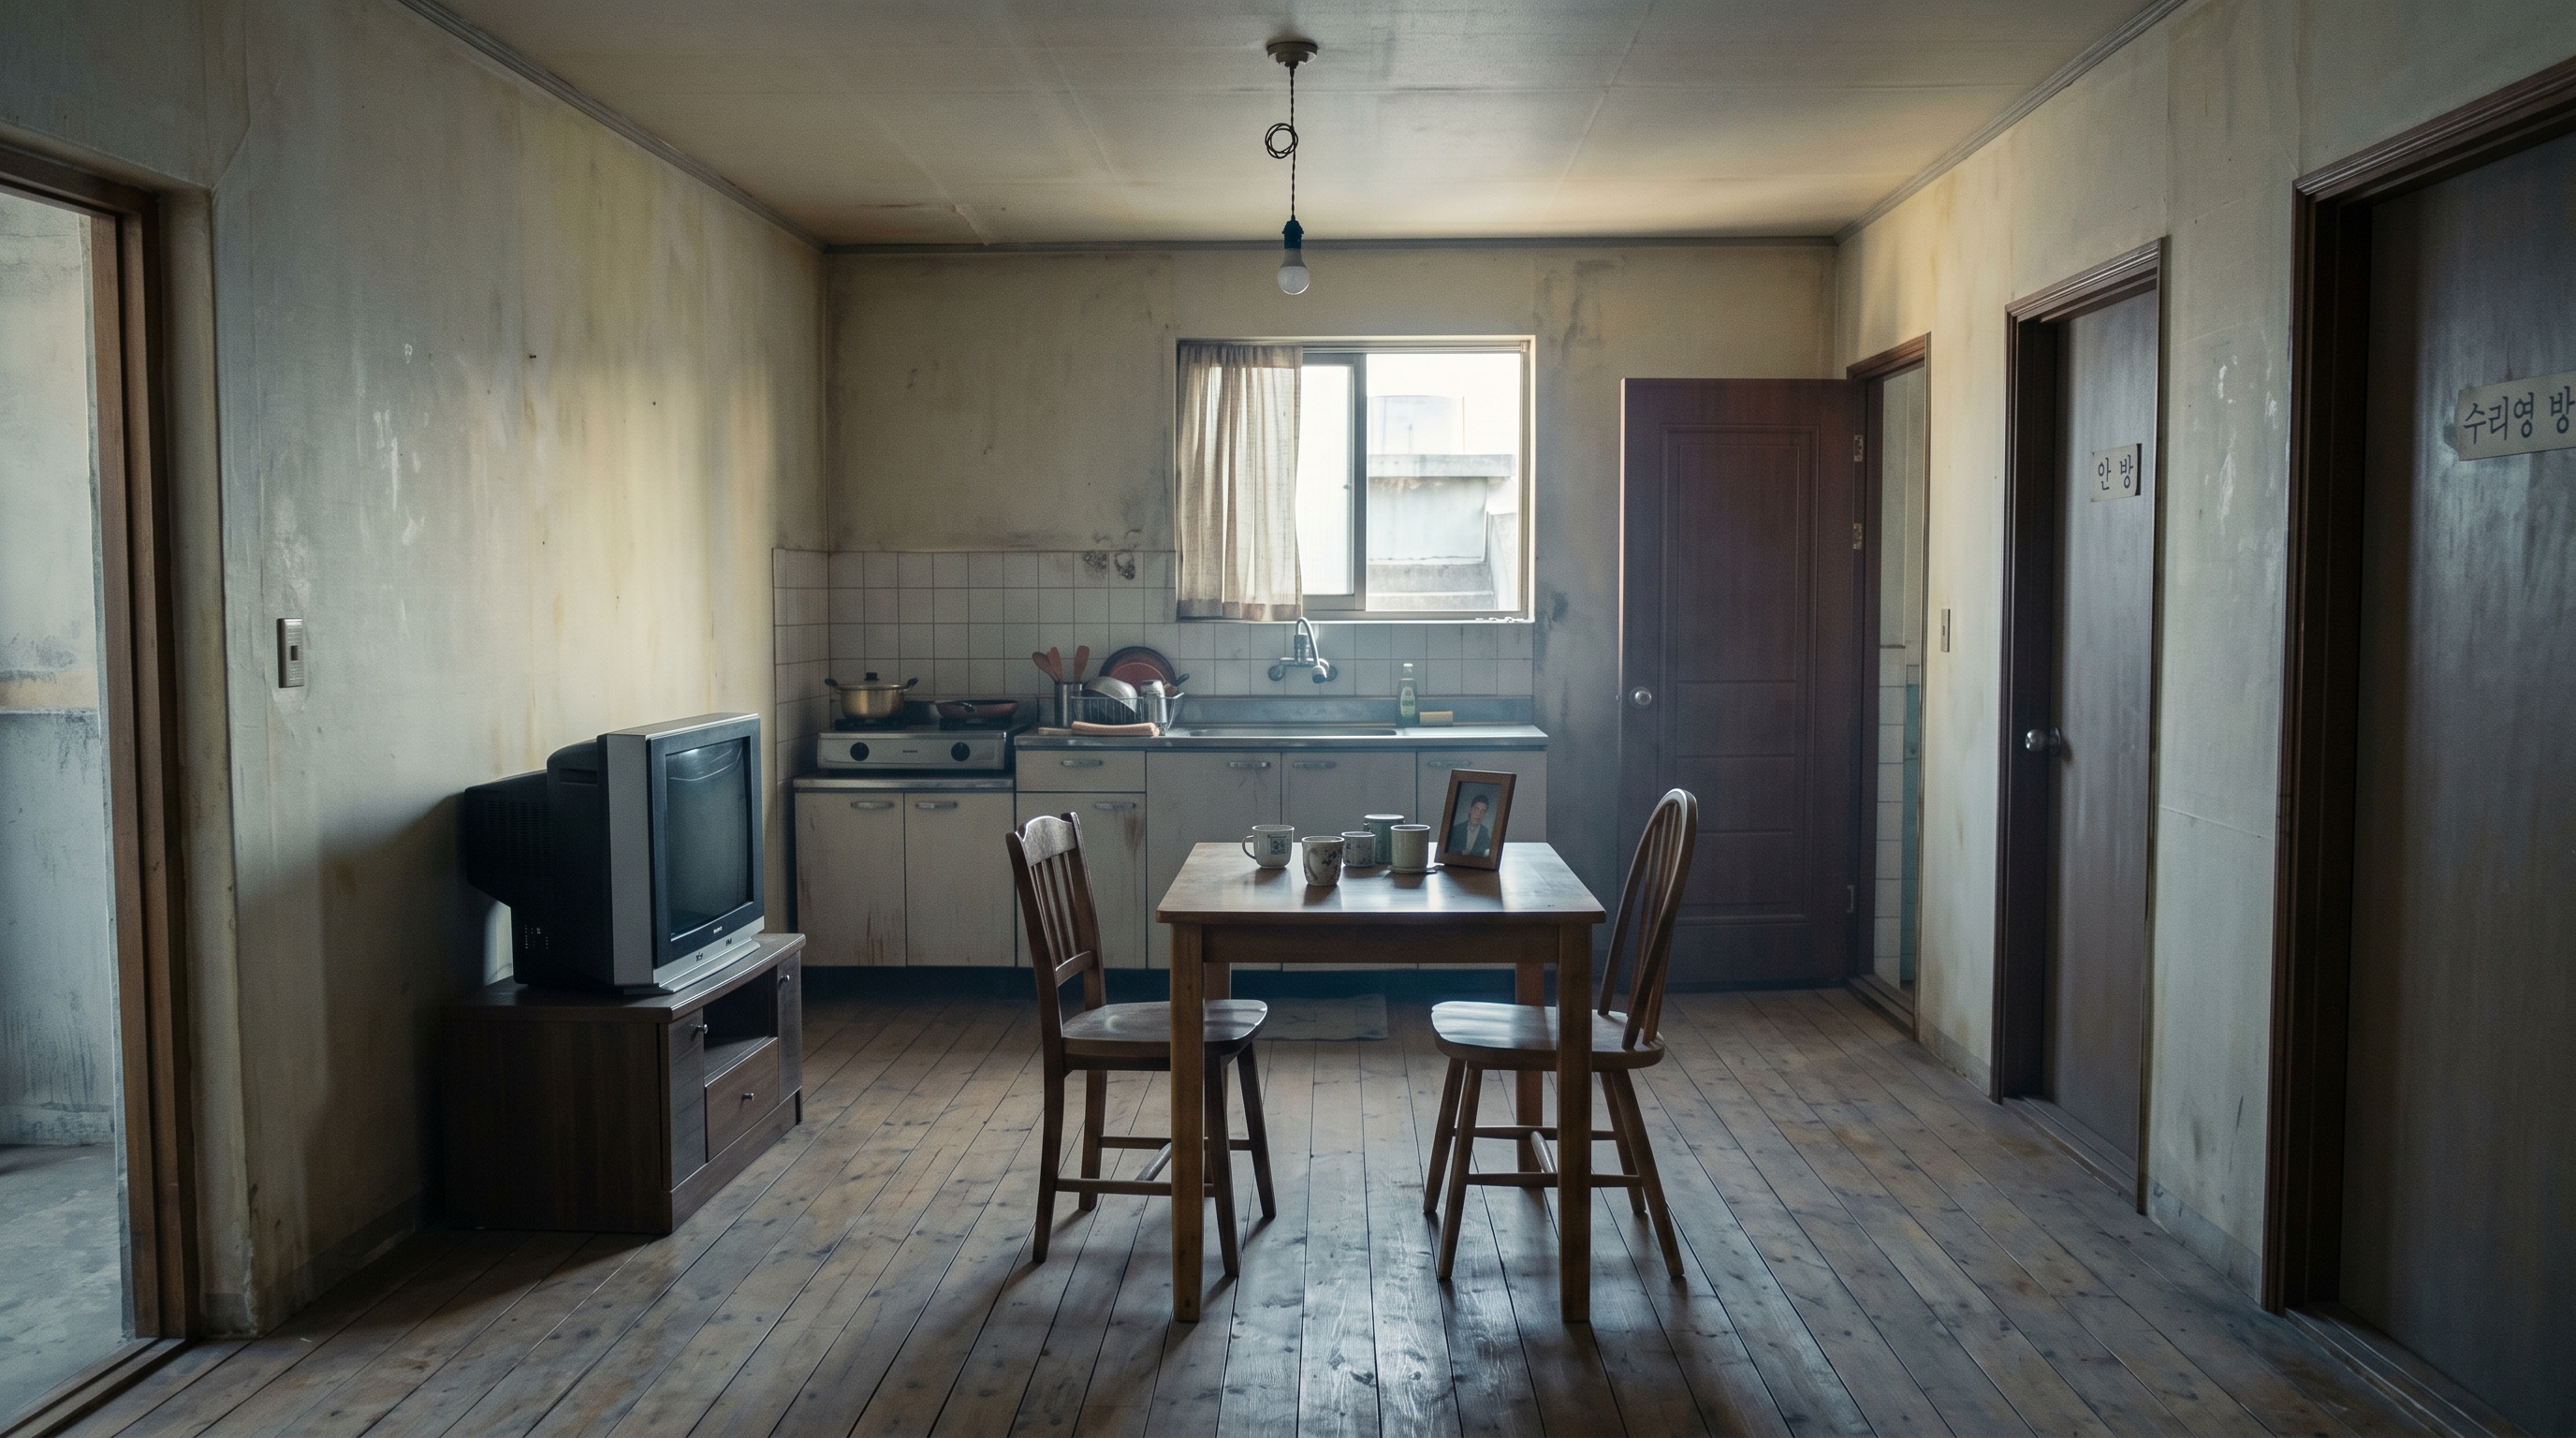
비교용 — variant F (S5_Shot3 정확 케이스) 결과: 31_chain_bg_v3_living_day.png (도면 PNG ref + photoreal prompt)
APARTMENT FLOOR LAYOUT (top-down view, 10m wide × 4m deep). +x=east, +y=north.

### LIVING/KITCHEN (거실 주방) [living]
  Position: LOWER-LEFT corner.
  Size: 6.0m wide (E-W) × 4.0m deep (N-S).
  Furniture:
    - TELEVISION (tv): 1.2m × 0.1m, on the LEFT wall (west wall, on camera-left), centered along the wall.
    - SOFA: 1.5m × 0.6m, on the RIGHT wall (east wall, on camera-right), centered along the wall.
    ...

FURNITURE FACING RULES:
  - The TV (LEFT wall) and the SOFA (RIGHT wall) FACE EACH OTHER ACROSS the room.
  - The kitchen SINK on the BACK wall faces toward the front (toward the camera).
변환 전체 텍스트: spec_gpt_natural_dsl.txt ·
full prompt: variant_d_prompt.txt
비교용: variant B (SVG XML) 두 결과 위에 / variant F (도면 PNG ref) 31_chain_bg_v3_living_day.png
              w
  MMMMMwwSSScwpwcS
  MbbbbwwSSSSSSSSS
  MbbbbwwSSSSbbbbb
  MbbbbbMbddSbbbbb
  MMMMIMMbdISbbbbb
     TTTLLLLLLLLLL
     LL,,tc,,LLLllw
     LL,,pc,,LLLll
RR   LLLttttLLLLLL
RREEELLLLLLLLLmBBB
RRFEILLLLLKKkkIKoo
RRsssLLLLLKKkkmKoo
RR
tv: [2, 5, 3, 5] = bbox cols 2-3 row 5.ROOMS: living_kitchen : [2, 1, 9, 5] # 거실 겸 부엌 main_bedroom : [1, 5, 4, 8] # 안방 small_bedroom : [4, 5, 9, 8] # 작은방 bathroom : [7, 1, 9, 3] # 욕실 FURNITURE: tv : [2, 5, 3, 5] # in living_kitchen, on top wall table : [4, 3, 5, 4] sink : [5, 1, 6, 1] # on bottom wall ...
시나리오(6 씬 + selected shots)
   ↓
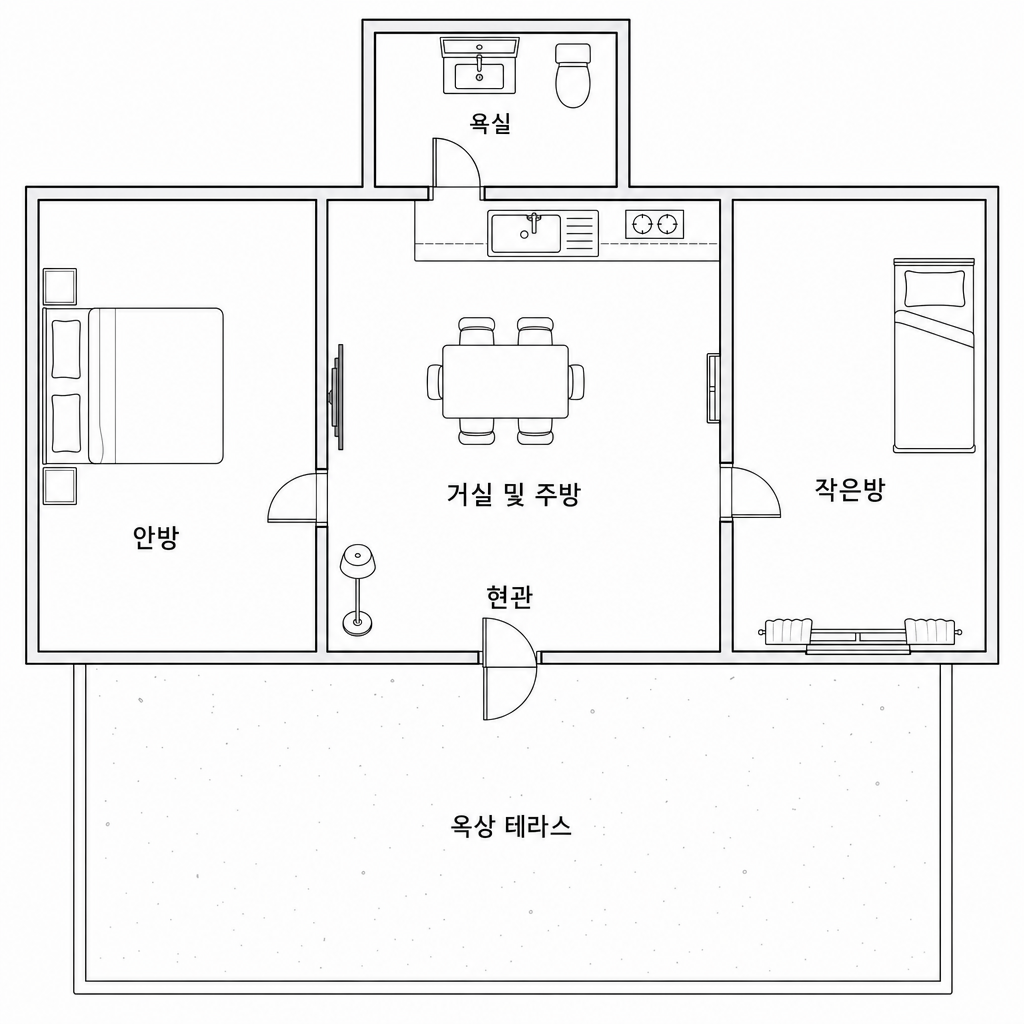
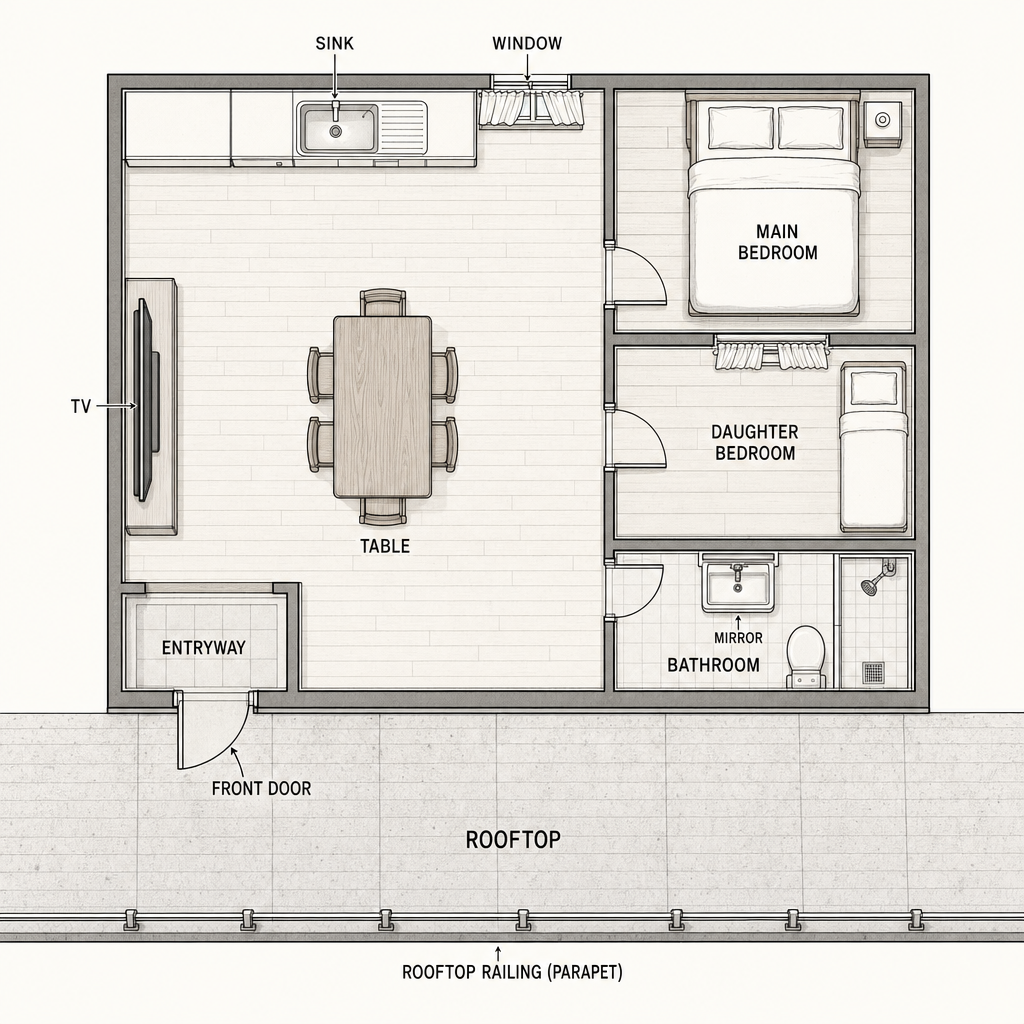
[Gemini Pro] 자동 prompt 작성 (1578자 영문)
   ↓
[gpt-image-2 text-to-image] 도면 PNG (자동본)
   ↓
[Gemini nano-banana-2] chain bg = image=[도면 PNG] + photoreal prompt
전체 prompt: auto_floor_plan_prompt.txt
| 결과 | 의미 | 다음 |
|---|---|---|
| 자동 도면 + chain bg가 수동 v3 + chain bg와 동급 정확 | spec.json/matplotlib 모두 제거. 가장 단순한 자동화 가능 | v2 plan 대폭 단순화 |
| 자동 도면이 부정확 (zone 누락, layout 모호) | LLM prompt 자동화로는 사람 v3 도달 못함 | vision validator + retry chain 추가 필요 |
| 도면은 OK인데 chain bg 결과 차이 큼 | 도면 자체가 layout authority로 작동 안 함 | 다른 접근 (사람 도면 업로드, 또는 도면 자체를 ref로 안 쓰고 prompt에만 의존) |
| variant | 입력 형태 | 입력 이미지 | 가설 | 예상 |
|---|---|---|---|---|
| F (검증됨) | 도면 PNG + photoreal prompt | 도면 PNG (sch.) | visual ref가 강력 | 정확 |
| B | SVG XML 텍스트 in prompt | 없음 | SVG는 모델이 vector graphics format으로 학습 | 부정확 (모델이 좌표 해석 X) |
| D | 자연어 spatial DSL in prompt | 없음 | "LEFT wall", "FACES across" 같은 spatial language는 학습 데이터 풍부 | B보다 정확, F에 가까울지 검증 |
| E | ASCII grid (char) | 없음 | 게임 맵, 코드 댓글의 ASCII art 학습 풍부 | 모델이 grid pattern을 layout으로 인식? |
| F | 좌표 array bbox (JSON-like) | 없음 | 가장 단순한 코드 형식, 모델이 코드 풍부하게 학습 | D/E보다 단순, 효과는? |
| 결과 | 분기 |
|---|---|
| 두 도면 모두 v3 수준으로 정확 | v2 plan SVG-first 그대로 진행. 모델 cost 차이로 선택. |
| 한쪽만 정확 | 해당 모델 사용. 다른 모델 fallback. |
| 양쪽 모두 부정확 (zone 위치 틀림) | hybrid: 사람 spec 작성 또는 prompt에 v3 layout hint 추가 |
| 좌표는 OK, 시각 표현만 부족 | SVG renderer 개선 (벽 두께, 가구 도형 디테일) |